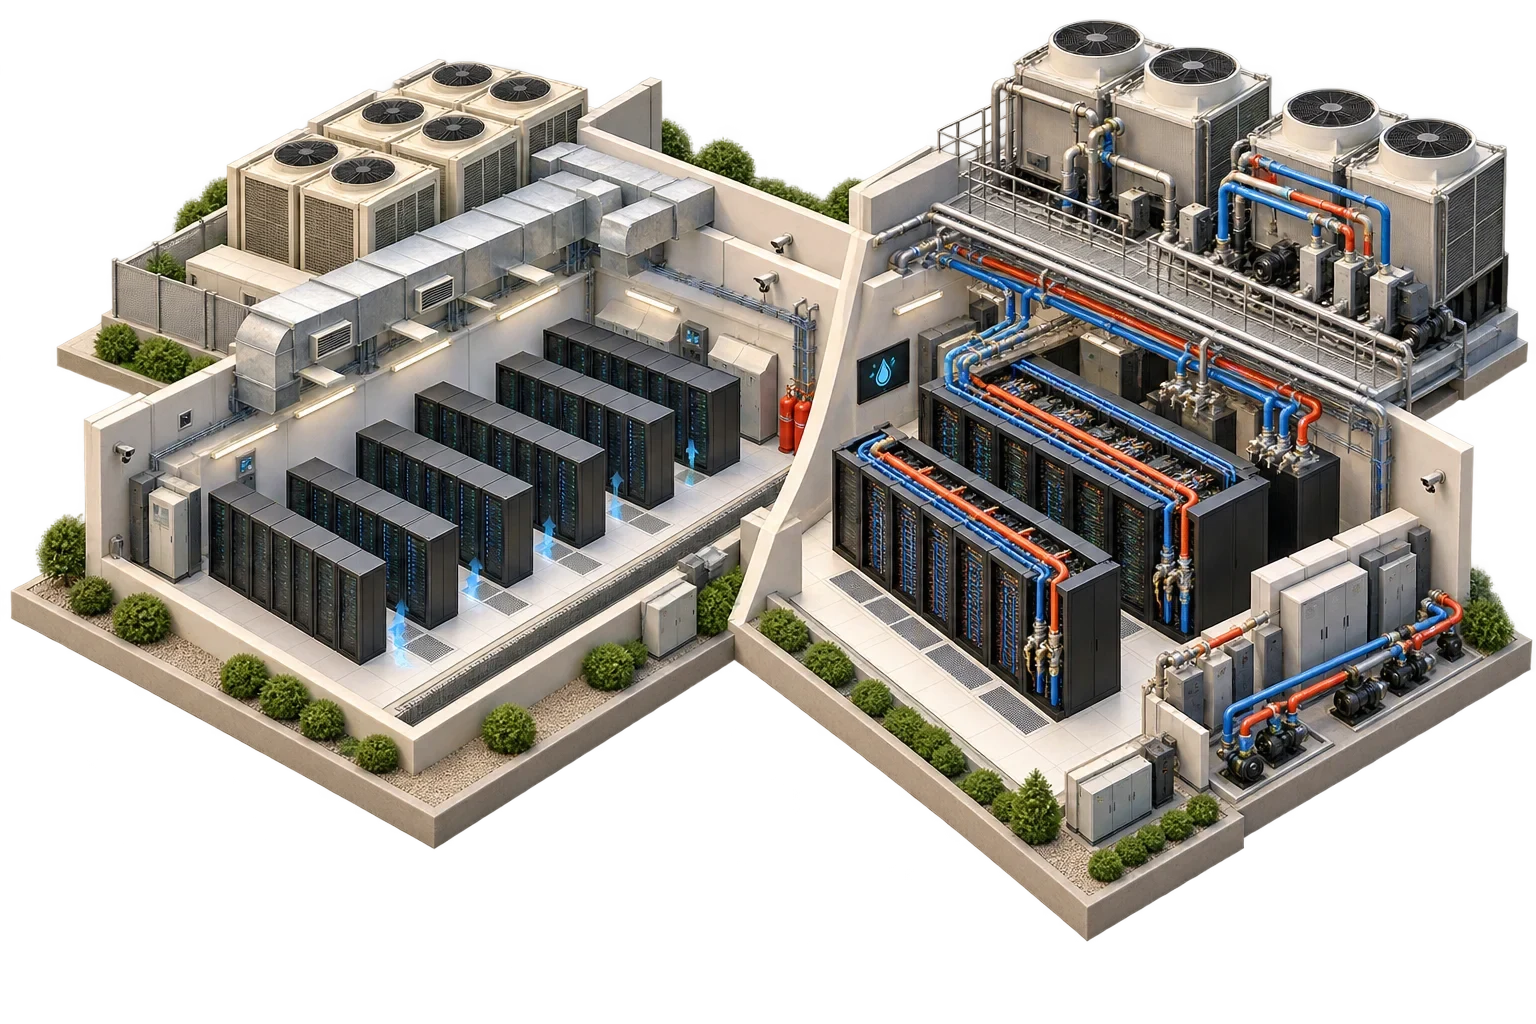
Un data center AI non è tanto un diverso tipo di edificio quanto un diverso tipo di carico. Le strutture costruite per il calcolo accelerato, dove server ricchi di GPU o acceleratori simili lavorano insieme, in genere concentrano molta più energia e calore in ciascun rack, dipendono molto di più dalla rete tra i server e funzionano quasi a pieno carico per lunghi periodi. Queste tre differenze si ripercuotono sulla distribuzione elettrica, sul raffreddamento, sul layout e sulle operazioni.
Tuttavia, non esiste un'unica configurazione AI. Un rack di server di inferenza che rispondono alle domande di un chatbot può assomigliare molto all'IT convenzionale, mentre un cluster che addestra un modello di grandi dimensioni può essere diverso da qualsiasi cosa per cui è stata progettata la stanza esistente. La decisione deve basarsi sull'attrezzatura e sul carico di lavoro effettivi, qualunque sia l'etichetta.
Dove si vedono le differenze
Aspetto
IT aziendale convenzionale
Grande cluster di calcolo accelerato
Potenza per rack
Varia, solitamente pianificata in base al tipo di rack
Concentrato; impostato dalla configurazione del produttore
Profilo di carico
Utilizzo variabile, spesso medio basso
Carico elevato sostenuto durante le esecuzioni di addestramento
Rete
Principalmente traffico client-server
Traffico server-to-server intenso su fabric dedicati
Driver di layout
Spazio e potenza per fila
Limiti di lunghezza dei cavi, alimentazione e raffreddamento per posizione nel rack
Impatto del guasto
Di solito un servizio
Un nodo guasto può interrompere un lavoro nel cluster
Raffreddamento
Raffreddamento ad aria comune
Raffreddamento ad aria ai limiti; raffreddamento a liquido sempre più comune
La densità è il titolo
La guida alla progettazione dei data center 2024 del Dipartimento dell'Energia degli Stati Uniti rileva che le strutture di calcolo ad alte prestazioni hanno registrato densità di rack di 60 kW per rack di calcolo nel 2013, con cifre recenti che hanno superato i 125 kW. Inoltre, l'utilizzo medio dei server negli ambienti aziendali è generalmente pari al 20-40%. I cluster di addestramento dell’IA spingono nella direzione opposta su entrambi i fronti: densi e impegnati.
Il valore per ogni particolare rack deve derivare dalla configurazione documentata dell'apparecchiatura acquistata, non da una regola empirica, e lo stesso vale per il metodo di raffreddamento. Il comitato per i data center di ASHRAE, TC 9.9, ha osservato in un white paper del 2021 che i chip per processori disponibili solo con raffreddamento a liquido erano già sul mercato, e altri in arrivo.
Ciò che conta di più è dove si concentra la domanda. Una struttura può avere capacità inutilizzata in totale e tuttavia non essere in grado di fornirla a rack particolari, quindi la distribuzione dell'alimentazione, l'erogazione del raffreddamento e il carico sul pavimento devono essere controllati nelle posizioni dei rack che si intende effettivamente utilizzare.
La rete diventa parte dell'edificio
La formazione distribuita dipende dalla comunicazione veloce tra i server. I progetti di riferimento pubblicati per cluster GPU di grandi dimensioni separano le reti di elaborazione, archiviazione e gestione e i loro fabric ad alta velocità stabiliscono la lunghezza massima dei cavi. Limiti come questi limitano la portata dei rack. Distribuire i rack per risolvere un problema di alimentazione o raffreddamento può compromettere la progettazione della rete.
Il guasto si comporta diversamente
Nell'IT convenzionale, la perdita di un server di solito influisce su un servizio. In un cluster di formazione, le linee guida del fornitore avvertono che il guasto di un singolo sistema in un lavoro multi-nodo può interrompere il lavoro su tutti loro. Ciò sposta l’attenzione sulle modalità di alimentazione, sulla continuità del raffreddamento e sui checkpoint nel software, e significa che i requisiti di resilienza della struttura dipendono dalla possibilità di riavviare il lavoro da uno stato salvato.
Quattro cose da avere in mano
Quattro cose dovrebbero essere sul tavolo prima che inizi la progettazione. Il fornitore deve fornire una configurazione documentata dell'apparecchiatura con i requisiti di alimentazione, raffreddamento e rete per rack. Dovrebbe esserci uno scenario di crescita che indichi quanti rack, di che tipo e quando. È necessario specificare i requisiti di resilienza del carico di lavoro, incluso se i lavori possono riprendere dopo un'interruzione. E dovrebbe esserci un piano di monitoraggio che colleghi le prestazioni IT alle condizioni della struttura, in modo che si manifesti un vincolo di raffreddamento che rallenta il cluster.
Applicazione pratica
Confronta questi quattro elementi con ciascuna opzione in un'unica tabella (la tua stanza esistente, una nuova o la struttura di un fornitore) e la risposta è spesso ovvia. Pagin Consulting compila questo confronto con gli specialisti elettrici e meccanici.
Quando il raffreddamento a liquido è realmente necessario per le apparecchiature di intelligenza artificiale, le opzioni disponibili e le interfacce di monitoraggio da pianificare.
5 minuti di lettura · Pubblicato il 26 agosto 2025
Le reti separate utilizzate dai cluster AI, il motivo per cui le strutture sono costruite per l'intera unità e come accettare le prestazioni del carico di lavoro.
4 minuti di lettura · Pubblicato il 22 gennaio 2026